USA oskarżają Chiny o masowe „destylowanie” AI
Amerykańskie służby twierdzą, że chińskie firmy AI masowo wyciągają wiedzę z modeli z USA, omijając zabezpieczenia i limity.
USA uderzają w chińskie firmy AI
Amerykańskie służby bezpieczeństwa oskarżyły kilka chińskich firm z branży sztucznej inteligencji o prowadzenie industrialnej skali „distillation”, czyli wyciąganie możliwości i zachowań z amerykańskich modeli frontier AI. W praktyce chodzi o serię masowych zapytań do komercyjnych modeli, których odpowiedzi mają później posłużyć do trenowania własnych systemów.
Wspólny komunikat wydały NSA, CISA i FBI. Według nich to nie poboczna praktyka, lecz jeden z filarów rozwoju AI w Chinach.
Jak miało wyglądać działanie
Służby twierdzą, że od co najmniej końca 2024 roku chińskie spółki kierowały do modeli z USA miliardy tokenów w ramach milionów interakcji. Celem miało być pozyskanie cech takich jak:
- reasoning i chain-of-thought,
- funkcje agentowe,
- kodowanie i analiza danych,
- generowanie tekstu,
- rozumienie obrazu i wideo.
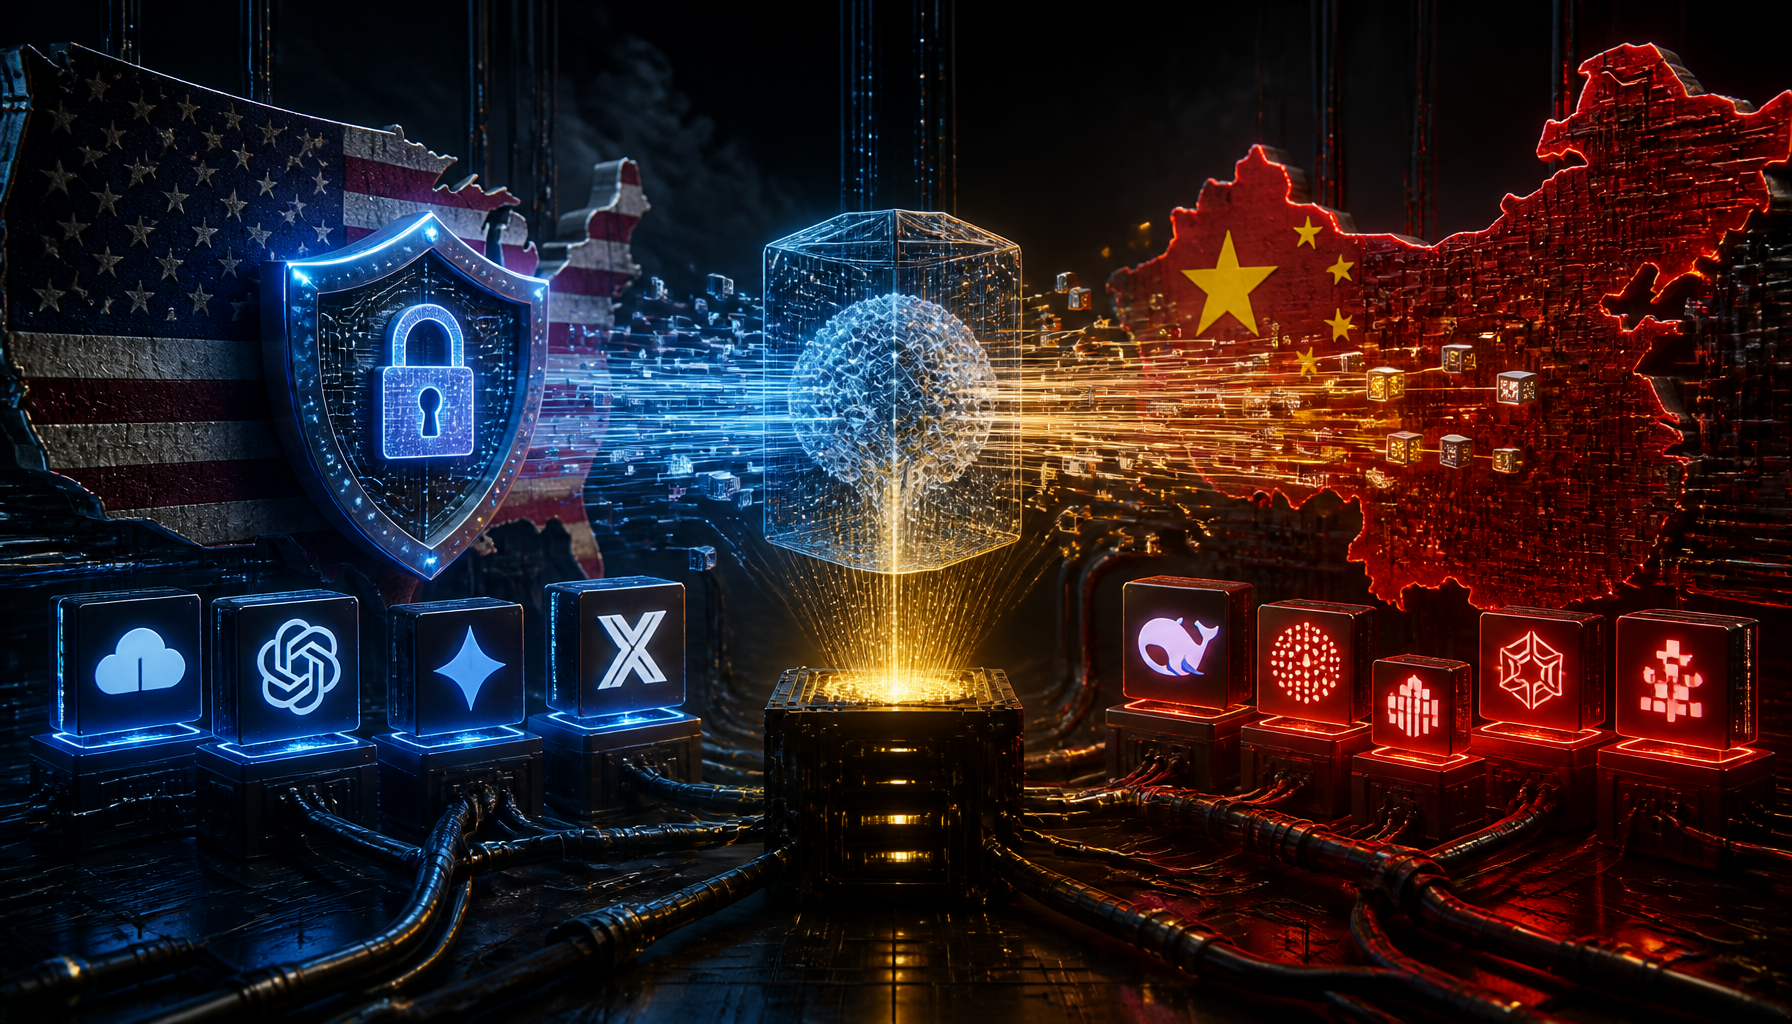
Wśród wymienionych podmiotów znalazły się m.in. DeepSeek, Moonshot AI, Alibaba, MiniMax, StepFun oraz Z.AI. Po drugiej stronie miały stać modele firm takich jak Anthropic Claude, OpenAI ChatGPT/GPT, Google Gemini oraz xAI Grok.
Które firmy znalazły się na liście
W materiale służb pojawiają się konkretne zarzuty wobec kilku podmiotów:
- DeepSeek miało wykorzystywać dane z modeli z USA do trenowania systemów R1 i V3,
- Moonshot AI miało pozyskiwać dane z różnych wariantów Claude i GPT-4o, by rozwijać Kimi-K2 i Kimi-K3,
- Alibaba miała używać modeli Claude i GPT-5 do poprawy funkcji programistycznych, dialogów obsługi klienta i generowania obrazów,
- MiniMax miało trenować M2 na podstawie danych z Claude, Gemini i innych modeli,
- StepFun miało sięgać po dane z kolejnych wersji Claude i GPT-5, by ulepszać Step 4,
- Z.AI miało wykorzystywać ogromne wolumeny danych z GPT-5.5 i Claude Opus 4.8 do rozwoju własnych zdolności reasoningowych.
Omijanie blokad i ukrywanie źródła ruchu
Według amerykańskich urzędników firmy te nie korzystały z jednego prostego kanału dostępu. Ruch miał być rozpraszany między różne:
- konta,
- platformy,
- modele,
- dostawców chmury,
- agregatory API.
W grę miały wchodzić także proxy, konta zautomatyzowane, obfuskacja metadanych użytkownika oraz obejścia ograniczeń geograficznych. Wspomniano również o szarej strefie pośredników i serwerów działających poza Chinami kontynentalnymi, a nawet o ofertach pojawiających się na chińskich marketplace’ach.
Taki model działania ma utrudniać wykrycie, że w rzeczywistości dochodzi do skoordynowanego pozyskiwania wiedzy z cudzych modeli, a nie do zwykłego korzystania z usługi.
Dlaczego to ważne dla rynku AI
Służby podkreślają, że distillation samo w sobie jest legalną i powszechnie znaną techniką badawczą. Problem zaczyna się wtedy, gdy jest używane masowo, w sposób celowy i wbrew zasadom korzystania z usług, by kopiować przewagę technologiczną konkurenta.
Amerykańskie firmy AI już wcześniej były oskarżane o nieuprawnione trenowanie modeli na cudzych materiałach, więc spór wokół własności intelektualnej w branży i tak jest bardzo gorący. Ten przypadek dodaje do tego jeszcze wątek bezpieczeństwa narodowego i potencjalnego wykorzystania skopiowanych zdolności w operacjach ofensywnych, kampaniach wpływu czy automatyzacji ataków.
Co proponują amerykańskie służby
W rekomendacjach pojawiają się przede wszystkim działania obronne po stronie firm rozwijających modele AI:
- lepsze wykrywanie nadużyć,
- łączenie sygnałów z różnych platform i dostawców,
- ograniczanie skutków podejrzanych prób pozyskiwania danych,
- współpraca między biznesem, administracją i sojusznikami.
Przekaz jest jasny: przy tak rozproszonych i dobrze finansowanych operacjach pojedyncza firma nie poradzi sobie sama.
Spór, który będzie narastał
Cała sprawa pokazuje, że wyścig o przewagę w AI coraz częściej toczy się nie tylko wokół mocy obliczeniowej czy jakości danych treningowych, lecz także wokół kontroli dostępu do modeli i umiejętności wykrywania nadużyć. Jeśli zarzuty się potwierdzą, może to oznaczać nowy etap rywalizacji technologicznej między USA a Chinami — tym razem prowadzony nie w laboratoriach, ale na styku API, chmury i polityki bezpieczeństwa.